
Resumen: cómo la detección de bots conductual estilo Reddit responde al movimiento aprendido
- La geometría no delata: El discurso de marketing del navegador sigiloso es que una trayectoria curvada del cursor derrota la detección de movimiento. No lo hace. Los humanizadores prefabricados, incluidas las curvas bezier, WindMouse y NaturalMouse, son atrapados el 97% al 100% de las veces por un modelo de movimiento de escritorio. La geometría nunca fue lo que delataba al bot.
- La herramienta human_nav: cside construyó human_nav, con tres políticas de aprendizaje por refuerzo para cursor, scroll y tecleo, entrenadas contra copias congeladas de detectores de cside. Contra críticos congelados alcanza la banda humana; contra un detector vivo desplazado, la separabilidad del scroll ronda AUC 0,77 y la cadencia puede caer fuera del rango humano.
- La ventaja del defensor: Si tu defensa es un modelo conductual estático, una política aprendida convergerá sobre él. Si recapturas el movimiento humano y reentrenas con un calendario, puntúas la coherencia entre canales y superpones el movimiento con señales de fingerprint, red y TLS, el atacante tiene que superar cada capa a la vez.
¿Poco tiempo? Consulta la detección de agentes de IA de cside. Cubre todo lo de abajo en un solo despliegue.
En un artículo anterior hicimos una afirmación. Sea como sea que un script dibuje el cursor, ya lo teletransporte directo al objetivo, siga una curva bezier o corra una librería de física como WindMouse o NaturalMouse, un modelo de movimiento lo atrapa igual. La forma de un movimiento es solo la mitad de lo que deja una mano. Mostramos que lo mismo vale para Playwright y la API "humanlike" de browserless.io.
Eso plantea la pregunta obvia desde el otro lado de la mesa. ¿Y si dejaras de dibujar la forma a mano y aprendieras el resto? Construimos la herramienta que lo hace. Se llama human_nav: una herramienta de red team de investigación que sintetiza movimiento humano de cursor, desplazamiento y pulsaciones de teclado para poner a prueba la detección de bots por comportamiento. Esto es lo que reveló sobre los sitios que más se apoyan en la biometría del comportamiento.
La versión corta:
- Los humanizadores de serie (curvas bezier, WindMouse, NaturalMouse) se atrapan del 97% al 100% de las veces con un modelo de movimiento de escritorio. La geometría nunca fue la respuesta.
- human_nav tira a la basura la geometría ajustada a mano. Tres pequeñas políticas de aprendizaje por refuerzo generan trayectorias de cursor, ventanas de desplazamiento y tiempos de pulsación, entrenadas con movimiento humano real: cadencia, reversiones, la pausa entre palabras.
- Frente a los detectores congelados con los que se entrenó, llega a la banda humana. Frente a un detector en vivo que ha derivado, la brecha se reabre. La separabilidad del desplazamiento ronda un AUC de 0,77, la política de cursor todavía puede quedar por encima de un umbral en vivo, y la cadencia de tecleo puede caer fuera del rango humano.
- El resultado va a favor de los defensores. La forma es un problema resuelto para el atacante. Lo que aún separa a una política de una persona es la estabilidad de la cadencia, la coherencia entre canales y un detector que sigue moviéndose.
Por qué estos son los objetivos difíciles
Las defensas contra bots que sobreviven a un operador competente no son las que comprueban si el navegador es headless. Esa batalla se ganó y se perdió hace años. Las defensas que aún muerden observan cómo se comporta la sesión: el micro-timing de un desplazamiento, la duda de un cursor, el ritmo del tecleo en una caja de búsqueda. Los grandes marketplaces, las redes profesionales y los feeds sociales de alta rotación, los Amazon, LinkedIn y Reddit de la web, se apoyan en esta capa, porque es la que un navegador sigiloso y un fingerprint limpio no superan gratis.
Eso los convierte en el objetivo correcto para apuntar una herramienta de red team por comportamiento. No para romperlos, sino para averiguar cuánto de esa capa de comportamiento es seguridad real y cuánto es un badén que se pliega en cuanto el movimiento viene de algo mejor que una curva bezier. Así que construimos ese algo mejor.
¿Qué es la biometría conductual?
La biometría conductual es la disciplina de identificar y distinguir usuarios de bots basándose en cómo se comportan, no en lo que presentan como credenciales. Donde la autenticación verifica una contraseña o un atributo del dispositivo, la biometría conductual lee el flujo continuo de señales que una persona produce al interactuar: la curva de un cursor mientras busca en la pantalla, el ritmo de las pulsaciones en un formulario, la física de un desplazamiento al entrar y rebotar.
Estos patrones son difíciles de falsificar porque reflejan millones de micro-decisiones tomadas por el sistema nervioso humano. El movimiento del cursor lleva la anticipación y la pequeña corrección que produce un brazo real. El tiempo de pulsación de teclas refleja los hábitos individuales: las pausas específicas en los límites de palabras, la duración del mantenimiento en las teclas que se pulsan mal con frecuencia. La dinámica de desplazamiento lleva la inercia de un pulgar que se ralentiza al final de una sección. Un proceso con guion no tiene nada de esto.
La biometría conductual es ahora una capa estándar en la detección de bots, la prevención del fraude y la puntuación del riesgo de sesión a escala. Las grandes plataformas la utilizan porque detecta la automatización que ya ha pasado las comprobaciones de huella digital del dispositivo y de navegador sin cabeza. cside usa señales conductuales como una capa en una cascada junto con huellas digitales del dispositivo, señales de red y características TLS, para que un bot que aprende a moverse como una mano aún tenga que superar todas las demás comprobaciones a la vez. El resto de esta entrada mide lo cerca que puede llegar una política de movimiento aprendido.
Cómo funciona human_nav
La idea es estrecha. No guionices el movimiento. Tómalo por muestreo de una política que aprendió qué aspecto tiene el movimiento humano. Tres modelos separados, cada uno una pequeña política de aprendizaje por refuerzo que corre localmente, cada uno dueño de un canal.
Cada movimiento, desplazamiento y pulsación se enruta a través de un servidor de políticas local antes de tocar la página. La automatización pide "muévete a B" o "escribe esto", y la política devuelve el movimiento exacto, punto por punto, para reproducirlo.
| Canal | Observación → acción | Emite | Parámetros |
|---|---|---|---|
| Cursor | 19 → 3 | trayectoria A→B de pasos (dx, dy, dt ms) | ~40k |
| Desplazamiento | 13 → 2 | ventana de rueda de ticks (dy, dt) | ~9k |
| Tecleo | 33 → 2 | tiempos (hold, flight) por tecla | ~35k |
Cada una es un MLP actor-crítico compacto entrenado con PPO: PyTorch puro, CPU, una política gaussiana con squashing tanh, normalización de observaciones en marcha, un bonus de entropía, una parada temprana por KL objetivo. Nada de eso es exótico. El optimizador nunca fue el punto. La recompensa sí.
Esto es lo que la distingue de cualquier humanizador de serie. Una librería bezier optimiza el aspecto de una trayectoria. Estas políticas se califican con copias congeladas de los propios detectores de cside, y se recompensan en el espacio de logits por producir movimiento que esos detectores leen como humano. No dibujan una curva más bonita. Resuelven aquello para lo que la curva solo fue siempre un sustituto.
Dentro de la política de cursor
El agente de cursor ve una observación de 19 dimensiones: el vector al objetivo, su último (dx, dy, dt), el índice de paso, la longitud acumulada de la trayectoria, el desplazamiento neto, estadísticas de velocidad y tiempo en marcha, un recuento de cambios de dirección, una razón de rectitud y una anticipación al siguiente waypoint. Ese estado cargado de acumuladores es deliberado. Los detectores leen la cinemática agregada de toda la trayectoria, así que a la política se le entregan estadísticos suficientes en marcha para exactamente los agregados por los que se la juzga. Actúa emitiendo un triple (dx, dy, dt) en cada paso, recortado a ±40 px y de 4 a 40 ms.
La recompensa es una puerta. Un bonus de llegada de 20 domina todo, así que la política primero aprende a llegar de verdad a B. Solo al llegar cobra una recompensa del detector, fijada al margen humano del crítico vinculante, el peor de dos evaluadores congelados: cursor_v2 (una cabeza MLP, umbral en torno a 0,992) y cursor_v1 (una cabeza LightGBM, umbral en torno a 0,828). Baja ambos por debajo del umbral a la vez y se gana un bonus de realismo encima. El entrenamiento recorre un currículo: primero navegación pura, luego presión creciente de los detectores contra ambos críticos a la vez. Pelear contra dos detectores a la vez es lo que mantiene las trayectorias limpias y suavemente curvadas, en lugar de colapsar en un artefacto que engaña a un evaluador y parece roto al otro.
Seis trayectorias A→B reales salidas directamente de la política, deterministas, muestran el cursor acelerando por el medio y suavizándose al entrar en el objetivo, la desaceleración en la aproximación que hace una mano en lugar de un deslizamiento a velocidad constante. La rectitud mediana entre ellas es de alrededor de 0,99, sobre 12 a 26 puntos, a unos 38 ms por paso. El tiempo por paso se mantiene casi plano en los treinta y pocos milisegundos. La política descubrió que el micro-timing estable, no el jitter, es lo que los detectores congelados leen como humano.
Esta solución es una aguja afilada y determinista. La acción media de la política es lo que cae en la banda humana. Muestréala de forma estocástica, o añádele tu propio ruido encima, y el realismo se desmorona. La aleatoriedad es exactamente lo que la automatización ingenua busca, y aquí es el delator. La victoria también es estrecha. Es un exploit adversario de un detector congelado, no movimiento humano certificado.
Desplazamiento y tecleo
La política de desplazamiento emite (dy, log1p(dt)) por cada tick de rueda. El tiempo se genera en espacio logarítmico y se mapea de vuelta, así que una sola política cubre desde ráfagas de menos de 10 ms hasta pausas de asentamiento de un segundo. Muestrea sus tareas de desplazamiento, la longitud, la distancia neta y las reversiones, de un banco de desplazamientos humanos reales. Cada ventana generada entra y sale con suavidad en lugar de subir en línea recta, y las reversiones de dirección caen en huecos más largos, una persona que se detiene antes de corregir.
La política de tecleo corre sobre una observación de 33 dimensiones cuya cola es un one-hot de las categorías de tecla actual y de las dos siguientes (letra, dígito, espacio, edición), y emite un par (hold, flight) por tecla. Los tiempos de hold se mantienen cerca de 150 ms, pero los huecos de flight llevan la señal.
| Tiempo de pulsación | Valor |
|---|---|
| Tiempo de hold | ~150 ms |
| Flight dentro de palabra | 250 a 350 ms |
| Flight en límite de palabra | ~850 ms |
La política aprendió a pausar entre palabras, un ritmo que un retardo fijo entre teclas nunca produce. Esa es toda la idea. Cambia la geometría escrita a mano por una política aprendida por canal, califícala contra un detector real, y déjala encontrar las partes del movimiento humano que una persona escribiendo mouse.move() nunca pensaría en codificar: la desaceleración en la aproximación, la pausa antes de una corrección, el compás entre palabras.
Dónde caen estas trayectorias
Una forma de ver lo que la política nos compró: toma un montón de trayectorias generadas, de los humanizadores ingenuos y de human_nav, reduce cada una a diez rasgos cinemáticos, y proyecta el conjunto a tres dimensiones con PCA. Las familias de recta con jitter y de bezier se sientan en sus propios grumos apretados, porque solo hay tantas maneras de dibujar una curva de aspecto suave. La política se extiende por una región más amplia y desordenada, más cercana a cómo se dispersa el movimiento real de una mano, que es la propiedad que una curva fija no puede producir.
Léelo con honestidad. La proyección cubre 440 trayectorias de cuatro generadores sintéticos, con el 77% de la varianza contenida en tres ejes. Compara generadores sintéticos entre sí, no contra capturas humanas reales. Así que el hallazgo es "la política ocupa una región distinta y más amplia que los humanizadores de serie", no "la política es indistinguible de un humano".
Cuánto se acerca de verdad
Aquí es donde la honestidad importa más que el titular. Frente a los detectores congelados con los que se entrenaron las políticas, ganan. Eso es lo que significa "entrenado contra ellos", y por sí solo no prueba casi nada. La prueba real es un detector que la política nunca ha visto, e idealmente uno que haya derivado desde entonces. Ahí el cuadro es mixto, y la mezcla es el hallazgo.
| Canal | Frente al detector congelado | Frente a un detector en vivo que ha derivado |
|---|---|---|
| Cursor | En la banda humana | Puede quedar por encima de un umbral en vivo. No es humano certificado. |
| Desplazamiento | En la banda humana | Separable en torno a un AUC de 0,77. Realista, no invisible. |
| Tecleo | En la banda humana | La tasa de pausa y la velocidad pueden caer fuera del rango humano. |
Lee esa tabla como debería hacerlo un defensor. Una política aprendida es un gran salto respecto a una curva bezier. Cierra la mayor parte de la brecha de geometría que los humanizadores de serie nunca tocan. Pero "plausiblemente humano frente al detector con el que me entrené" no es "humano". En cuanto el detector del otro lado es uno que nunca estudió, o uno que se ha movido desde el entrenamiento, la señal residual vuelve. El realismo del movimiento decae con la deriva, y la deriva es lo único que un defensor controla del todo.
Qué significa esto si ejecutas detección por comportamiento
Se siguen unas cuantas cosas, y son la razón por la que construimos herramientas de red team.
Primero, no despliegues una comprobación por comportamiento y la congeles. Cualquier política entrenada contra un detector estático acabará igualándolo. La defensa más eficaz de esa tabla es la columna de la derecha: recapturar y reentrenar según un calendario. Eso no es mantenimiento, es el mecanismo de verdad. Un detector que se mueve más rápido de lo que un atacante puede reentrenar es uno con el que nunca converge.
Segundo, califica la coherencia, no los canales por separado. Una política que clava el movimiento del cursor y una política que clava el tecleo siguen siendo dos muestreadores separados. Las correlaciones que produce una persona real entre moverse, desplazarse y teclear son mucho más difíciles de falsificar que cualquier canal individual, porque nadie entrenó una política sobre la distribución conjunta. Esa costura es donde un conjunto de buenas falsificaciones de un solo canal se deshace.
Tercero, mantén el comportamiento como una capa, no la capa. El movimiento por comportamiento es potente, y también es la capa más expuesta a un humanizador decidido. Combínalo con señales de fingerprint, red y TLS, la manera en que la pila de cside decide is_bot como una llamada combinada en lugar de fiarse de un solo modelo, y un operador tiene que vencer todas las capas a la vez, no solo aquella en la que hundió una política aprendida. Ese es el argumento a favor de una cascada, y es por lo que la detección de bots aguanta cuando una sola comprobación se plegaría.
Divulgación responsable. Este informe cubre la técnica y sus límites al nivel de resultados. Deja fuera los internos del detector, los umbrales, las definiciones de rasgos por canal y cualquier procedimiento de ajuste, la misma línea que mantienen nuestros otros artículos públicos. La herramienta en sí está disponible para descargar más abajo. Cualquier cosa aquí que toque una plataforma externa se compartió con esa plataforma antes de la publicación.
Agentes de navegación impulsados por LLM: una nueva firma conductual
human_nav describe una clase de ataque: un desarrollador que optimiza explícitamente el movimiento contra un detector conocido. Una segunda clase emergió en 2025 y 2026: automatización del navegador impulsada por grandes modelos de lenguaje, donde el agente no es una política entrenada en movimiento sino un modelo de razonamiento que dirige un navegador Playwright o Puppeteer mediante visión y llamadas a herramientas.
Los agentes de navegación impulsados por LLM no se mueven como los bots con guion, ni se mueven como human_nav. Tienen su propia firma conductual, que un detector construido para cualquiera de las clases de ataque anteriores puede pasar por alto por completo.
Los patrones característicos:
- Cadencia de latencia de API. Un agente LLM hace una pausa mientras el modelo razona sobre la siguiente acción, luego ejecuta un clic con precisión inusual. Los intervalos entre acciones reflejan el tiempo de inferencia, no la deliberación humana. Los clics llegan sin hesitación en el seguimiento de trayectoria y sin correcciones de sobreimpulso.
- Patrones de exploración metódica. Un modelo de lenguaje dirigido a rellenar un formulario lee toda la página antes de empezar. El movimiento del cursor refleja un escaneo sistemático de arriba a abajo que no se parece nada al movimiento dirigido a un objetivo de una persona que ya sabe dónde está el campo de destino.
- Ráfagas de temporización. Las acciones disparadas desde una única invocación del modelo llegan en grupos cuyos intervalos entre acciones reflejan la tasa de tokens de salida del modelo en lugar de cualquier ritmo humano.
Estas firmas son significativas para una comprobación conductual no entrenada en ellas. También son legibles junto con las señales de capa de fingerprint y red, porque las sesiones de navegador dirigidas por máquina siguen ejecutándose en infraestructura identificable.
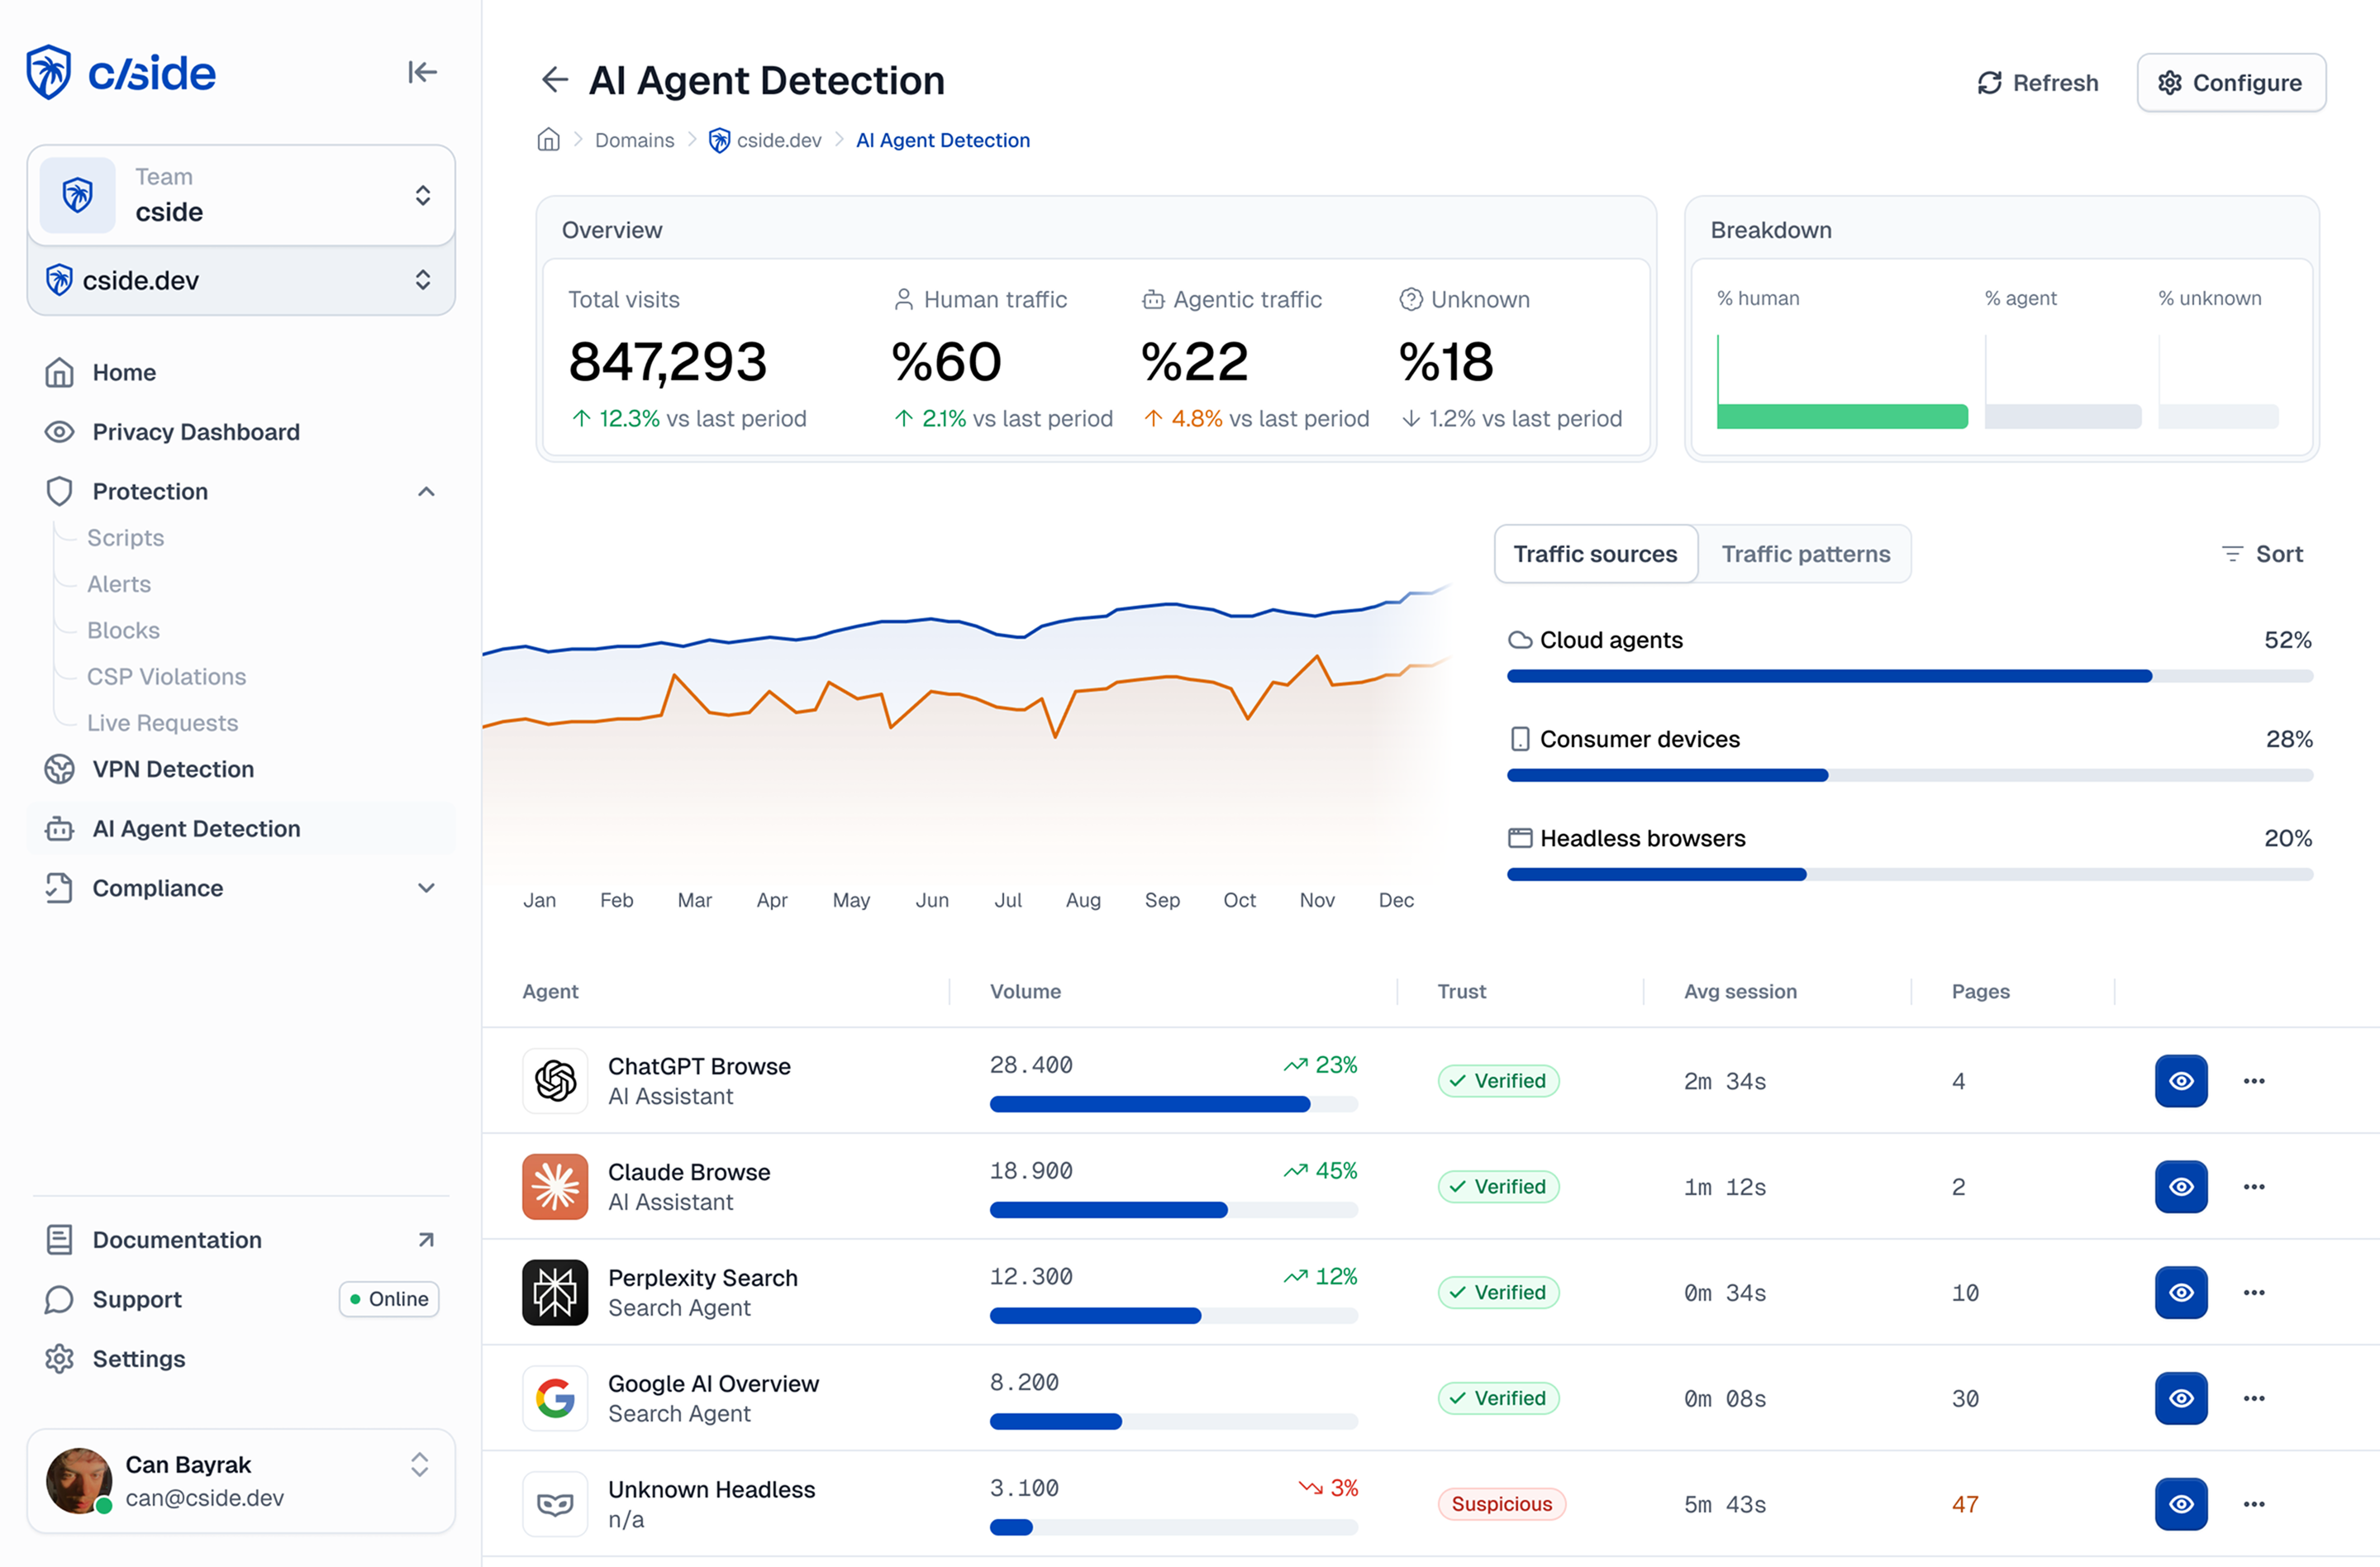
La lección de human_nav se mantiene: puntuar la coherencia entre canales, movimiento, fingerprint, red y temporización, es lo que una política aprendida no puede superar todo a la vez, ya sea que esa política sea un agente de RL o un modelo de razonamiento que dirige un navegador. La detección de agentes de IA de cside aplica exactamente esa cascada a cada sesión.
El sentido de construir al atacante
Es fácil leer human_nav como una herramienta de evasión que casualmente vive en una tienda de detección. La construimos por la razón contraria. La única forma de saber si una defensa por comportamiento es seguridad real o un badén es construir el mejor atacante que puedas y medir exactamente dónde deja de funcionar. La respuesta aquí es útil de cualquier modo. El movimiento aprendido supera a la geometría, y aun así no supera a un detector que sigue moviéndose y lee más de un canal a la vez. Ese es un resultado incómodo si vendes automatización "humanlike", y tranquilizador si tu trabajo es mantener fuera a los bots.
cside te muestra cada script y sesión que toca tu sitio, incluida la automatización que ha aprendido a moverse como una mano. Mira qué se está ejecutando de verdad en los navegadores de tus usuarios.