
Resumo: bloquear ClaudeBot sem impedir agentes Claude de navegar no teu site
- Crawler versus agente: As equipas bloqueiam o ClaudeBot à espera de que o Claude desapareça do seu site, e no dia seguinte o Claude Computer Use entra a caminhar. O ClaudeBot é o crawler de treino da Anthropic; os agentes alimentados pelo Claude que navegam a web usam infraestrutura e user-agents diferentes.
- O bloqueio por robots.txt: O ClaudeBot identifica-se como
ClaudeBot/1.0, está documentado nas páginas de crawler da Anthropic e respeita o robots.txt de forma fiável; umDisallow: /mais os intervalos de IP publicados da Anthropic na firewall cobrem numa só camada de aplicação tanto a leitura do robots.txt como o comportamento não conforme. - A decisão: Se queres sair dos dados de treino do Claude, esta alteração de um ficheiro resolve. Se também queres manter o Claude Computer Use fora do teu checkout, esse é um problema de deteção separado que precisa de sinais ao nível do navegador.
Sem tempo? Veja a deteção de agentes de IA da cside. Cobre tudo o que se segue numa única implementação.
O ClaudeBot é o rastreador web operado pela Anthropic para recolher dados de treino para o Claude. É um rastreador declarado, baseado em HTTP: identifica-se, opera a partir de intervalos de IP publicados e foi concebido para respeitar as diretivas do robots.txt. Bloqueá-lo é tecnicamente simples.
O contexto mais importante: bloquear o ClaudeBot atua sobre o pipeline de dados de treino da Anthropic. Não tem qualquer efeito sobre agentes, ferramentas ou produtos alimentados pelo Claude que navegam na web em nome dos utilizadores. Esses são sistemas separados que requerem deteção na camada do navegador. Para o padrão mais amplo entre os scrapers de IA, consulte o nosso guia para bloquear bots de scraping de conteúdo com agentes de IA.
O que É o ClaudeBot?
Resposta rápida: O ClaudeBot é o rastreador de treino da Anthropic. Ele recolhe conteúdo web publicamente disponível para treinar e melhorar os modelos Claude. Usa uma string de agente de utilizador declarada (
ClaudeBot/1.0) e está listado na documentação pública da Anthropic juntamente com os seus intervalos de IP. É um rastreador HTTP, não um agente de navegador interativo.
A string de agente de utilizador do ClaudeBot identifica-se como ClaudeBot/1.0, seguida de uma referência à página de documentação do rastreador da Anthropic. A string completa tem a forma:
ClaudeBot/1.0 (+https://anthropic.com/claude-bot)
A Anthropic mantém documentação que descreve o propósito do rastreador, o seu comportamento e como bloqueá-lo em anthropic.com/claude-bot.
Tal como o GPTBot, o ClaudeBot não executa JavaScript nem interage com interfaces de aplicações web. Ele faz requisições HTTP GET a URLs publicamente acessíveis, lê a resposta e segue em frente. Não inicia sessão, não preenche formulários nem navega por elementos interativos.
Como Bloquear o ClaudeBot com o robots.txt
Resposta rápida: Adicione
ClaudeBotao seurobots.txtpara bloquear o rastreador por completo. A documentação da Anthropic indica que o ClaudeBot respeita estas diretivas. Use regras ao nível dos caminhos se quiser restringir apenas secções sensíveis enquanto permite o rastreador no conteúdo público.
Para bloquear o ClaudeBot em todo o seu site:
User-agent: ClaudeBot
Disallow: /
Para permitir o rastreador no conteúdo público mas restringir caminhos sensíveis:
User-agent: ClaudeBot
Disallow: /account/
Disallow: /checkout/
Disallow: /admin/
Allow: /blog/
Allow: /products/
A Anthropic tem uma boa reputação de conformidade no que toca aos seus rastreadores respeitarem as regras do robots.txt. Esta é a abordagem mais simples e mais amplamente eficaz para controlar o acesso do ClaudeBot sem alterações ao nível da infraestrutura. A mesma abordagem com o robots.txt funciona para outros rastreadores declarados, incluindo o CCBot e o Bytespider.
Intervalos de IP do ClaudeBot
Resposta rápida: A Anthropic publica os intervalos de IP do ClaudeBot em
anthropic.com/claude-bot. Negar esses intervalos no seu CDN ou firewall proporciona uma aplicação independente de o rastreador ler o robots.txt. Os intervalos mudam à medida que a Anthropic escala a sua infraestrutura, por isso é preferível obtê-los da documentação da Anthropic em vez de codificar uma instantânea.
A Anthropic mantém uma lista atualizada dos intervalos de IP do ClaudeBot na sua página de documentação do rastreador. O bloqueio ao nível de IP oferece:
- Uma aplicação que não depende de o rastreador ler o
robots.txt - Um registo ao nível do servidor das requisições bloqueadas que pode auditar
- Proteção contra qualquer versão do rastreador que possa não lidar corretamente com o
robots.txt
Configure um lembrete para consultar a documentação da Anthropic trimestralmente quando atualizar os intervalos de IP da sua infraestrutura de rastreio.
Regras de Bloqueio Específicas por Plataforma
Nginx
Bloqueie o ClaudeBot por user-agent no seu bloco de servidor Nginx:
# bloquear por token de user-agent
if ($http_user_agent ~* "ClaudeBot") {
    return 403;
}
Para bloquear por intervalo de IP (substitua pelos intervalos atuais da documentação da Anthropic):
geo $block_claudebot {
    default 0;
    # adicione os intervalos de IP atuais do ClaudeBot de anthropic.com/claude-bot
    # 198.51.100.0/24 1;
}

server {
    if ($block_claudebot) {
        return 403;
    }
}
Apache
Adicione ao seu .htaccess ou bloco VirtualHost:
# bloquear por user-agent
BrowserMatch "ClaudeBot" bad_bot
Order Allow,Deny
Allow from all
Deny from env=bad_bot
Ou com mod_rewrite:
RewriteCond %{HTTP_USER_AGENT} ClaudeBot [NC]
RewriteRule .* - [F,L]
Cloudflare
Em Segurança > WAF > Regras personalizadas, crie uma regra:
- Campo: Agente de utilizador
- Operador: contém
- Valor:
ClaudeBot - Ação: Bloquear
Para bloqueio por IP, adicione os intervalos de IP atuais do ClaudeBot da documentação da Anthropic como regra de acesso IP em Segurança > WAF > Ferramentas.
Bloqueio ao Nível de IP para o ClaudeBot
Resposta rápida: A Anthropic publica os intervalos de IP do ClaudeBot na sua documentação do rastreador. Negar estes intervalos na sua firewall ou CDN fornece uma aplicação que não depende de o rastreador ler o
robots.txt. Verifique a documentação periodicamente, pois os intervalos de IP podem expandir-se quando a Anthropic escala a infraestrutura de rastreio.
O bloqueio ao nível de IP é a opção de aplicação mais robusta:
- Apanha qualquer versão do rastreador que possa não lidar corretamente com o
robots.txt - Cria um registo ao nível do servidor das requisições bloqueadas que pode auditar
- Não depende da autoidentificação através da string de agente de utilizador
O compromisso: os intervalos de IP publicados pela Anthropic requerem manutenção. Se os bloquear ao nível da firewall, defina um lembrete para verificar atualizações de intervalos trimestralmente ou quando a Anthropic publicar entradas no changelog da sua documentação do rastreador.
ClaudeBot vs. Agentes Alimentados pelo Claude: A Lacuna que Importa
Resposta rápida: O ClaudeBot é o rastreador da Anthropic. O Claude, o assistente, é um produto diferente. Quando o Claude ajuda um utilizador a navegar na web, pesquisar um tópico ou concluir uma tarefa, ele usa infraestrutura diferente da do ClaudeBot. Bloquear o ClaudeBot não impede que agentes alimentados pelo Claude visitem o seu site.
Esta é a mesma lacuna estrutural que se aplica ao GPTBot e ao OpenAI Operator. O rastreador de treino e o agente interativo são sistemas separados.
Quando um utilizador pede ao Claude para pesquisar um produto, comparar preços ou concluir uma tarefa baseada na web, o Claude usa uma sessão de navegador ou uma ferramenta de pesquisa web que não é o ClaudeBot. Essa sessão pode não ter quaisquer cabeçalhos identificadores que a liguem à Anthropic. Da perspetiva do seu servidor, parece uma requisição de navegador padrão.
O modelo mental correto: o robots.txt e o bloqueio de IP gerem a sua relação com o pipeline de recolha de dados da Anthropic. Eles não gerem a sua relação com o Claude enquanto produto a ser usado por utilizadores reais para interagir com o seu site.
O que Acontece Depois de Bloquear o ClaudeBot
Resposta rápida: Bloquear o ClaudeBot impede que o seu conteúdo entre no pipeline de dados de treino da Anthropic. Não impede que o Claude faça referência ao seu site nas respostas com base em conteúdo previamente indexado. Não impede que sistemas agênticos alimentados pelo Claude naveguem no seu site em nome dos utilizadores.
Depois de um bloqueio do ClaudeBot:
- As futuras execuções de treino não incluirão o seu novo conteúdo
- O conteúdo previamente recolhido permanece nos pesos dos modelos Claude existentes
- Os utilizadores do Claude que lhe pedem para navegar no seu site não são afetados
- Qualquer agente alimentado pelo Claude (utilização do computador no Claude.ai, agentes da API do Claude) que visite o seu site não é afetado
O alcance de um bloqueio com robots.txt é mais estreito do que a maioria dos proprietários de sites espera. É uma declaração sobre um rastreador específico, não uma política que se aplica a todo o portefólio de produtos de uma empresa de IA.
Deteção na Camada do Navegador para Além do ClaudeBot
Resposta rápida: Bloquear o ClaudeBot é simples. O problema mais difícil é detetar agentes alimentados pelo Claude a navegar no seu site em sessões de navegador reais, em nome dos utilizadores, sessões que parecem idênticas ao tráfego humano na camada de rede. Isso requer observação na camada do navegador.
Considere o que um agente de utilização de computador alimentado pelo Claude realmente faz quando um utilizador lhe pede para pesquisar um produto SaaS. Ele abre uma sessão Chromium real, carrega a página de preços e percorre a tabela de funcionalidades. Na camada de rede, a requisição parece idêntica a uma visita humana: um agente de utilizador padrão do Chrome, um IP residencial, uma impressão digital TLS dentro do intervalo. Sem cabeçalho do ClaudeBot. Sem intervalo de IP da Anthropic. O agente navega por quatro páginas em 11 segundos sem uma única variância de movimento do rato, nunca volta atrás e nunca faz pausa num campo de formulário a menos que a tarefa exija introdução de dados. Esses sinais de tempo e padrões de interação só são detetáveis dentro da sessão do navegador. A instrumentação da cside captura-os na camada de execução de JavaScript antes que qualquer ferramenta ao nível de rede os consiga ver. Nos testes controlados da cside, as ferramentas tradicionais não detetaram agentes de IA a operar dentro de sessões de navegador reais em 81 de 100 cenários: as ferramentas de rede simplesmente não estão a observar a camada certa.
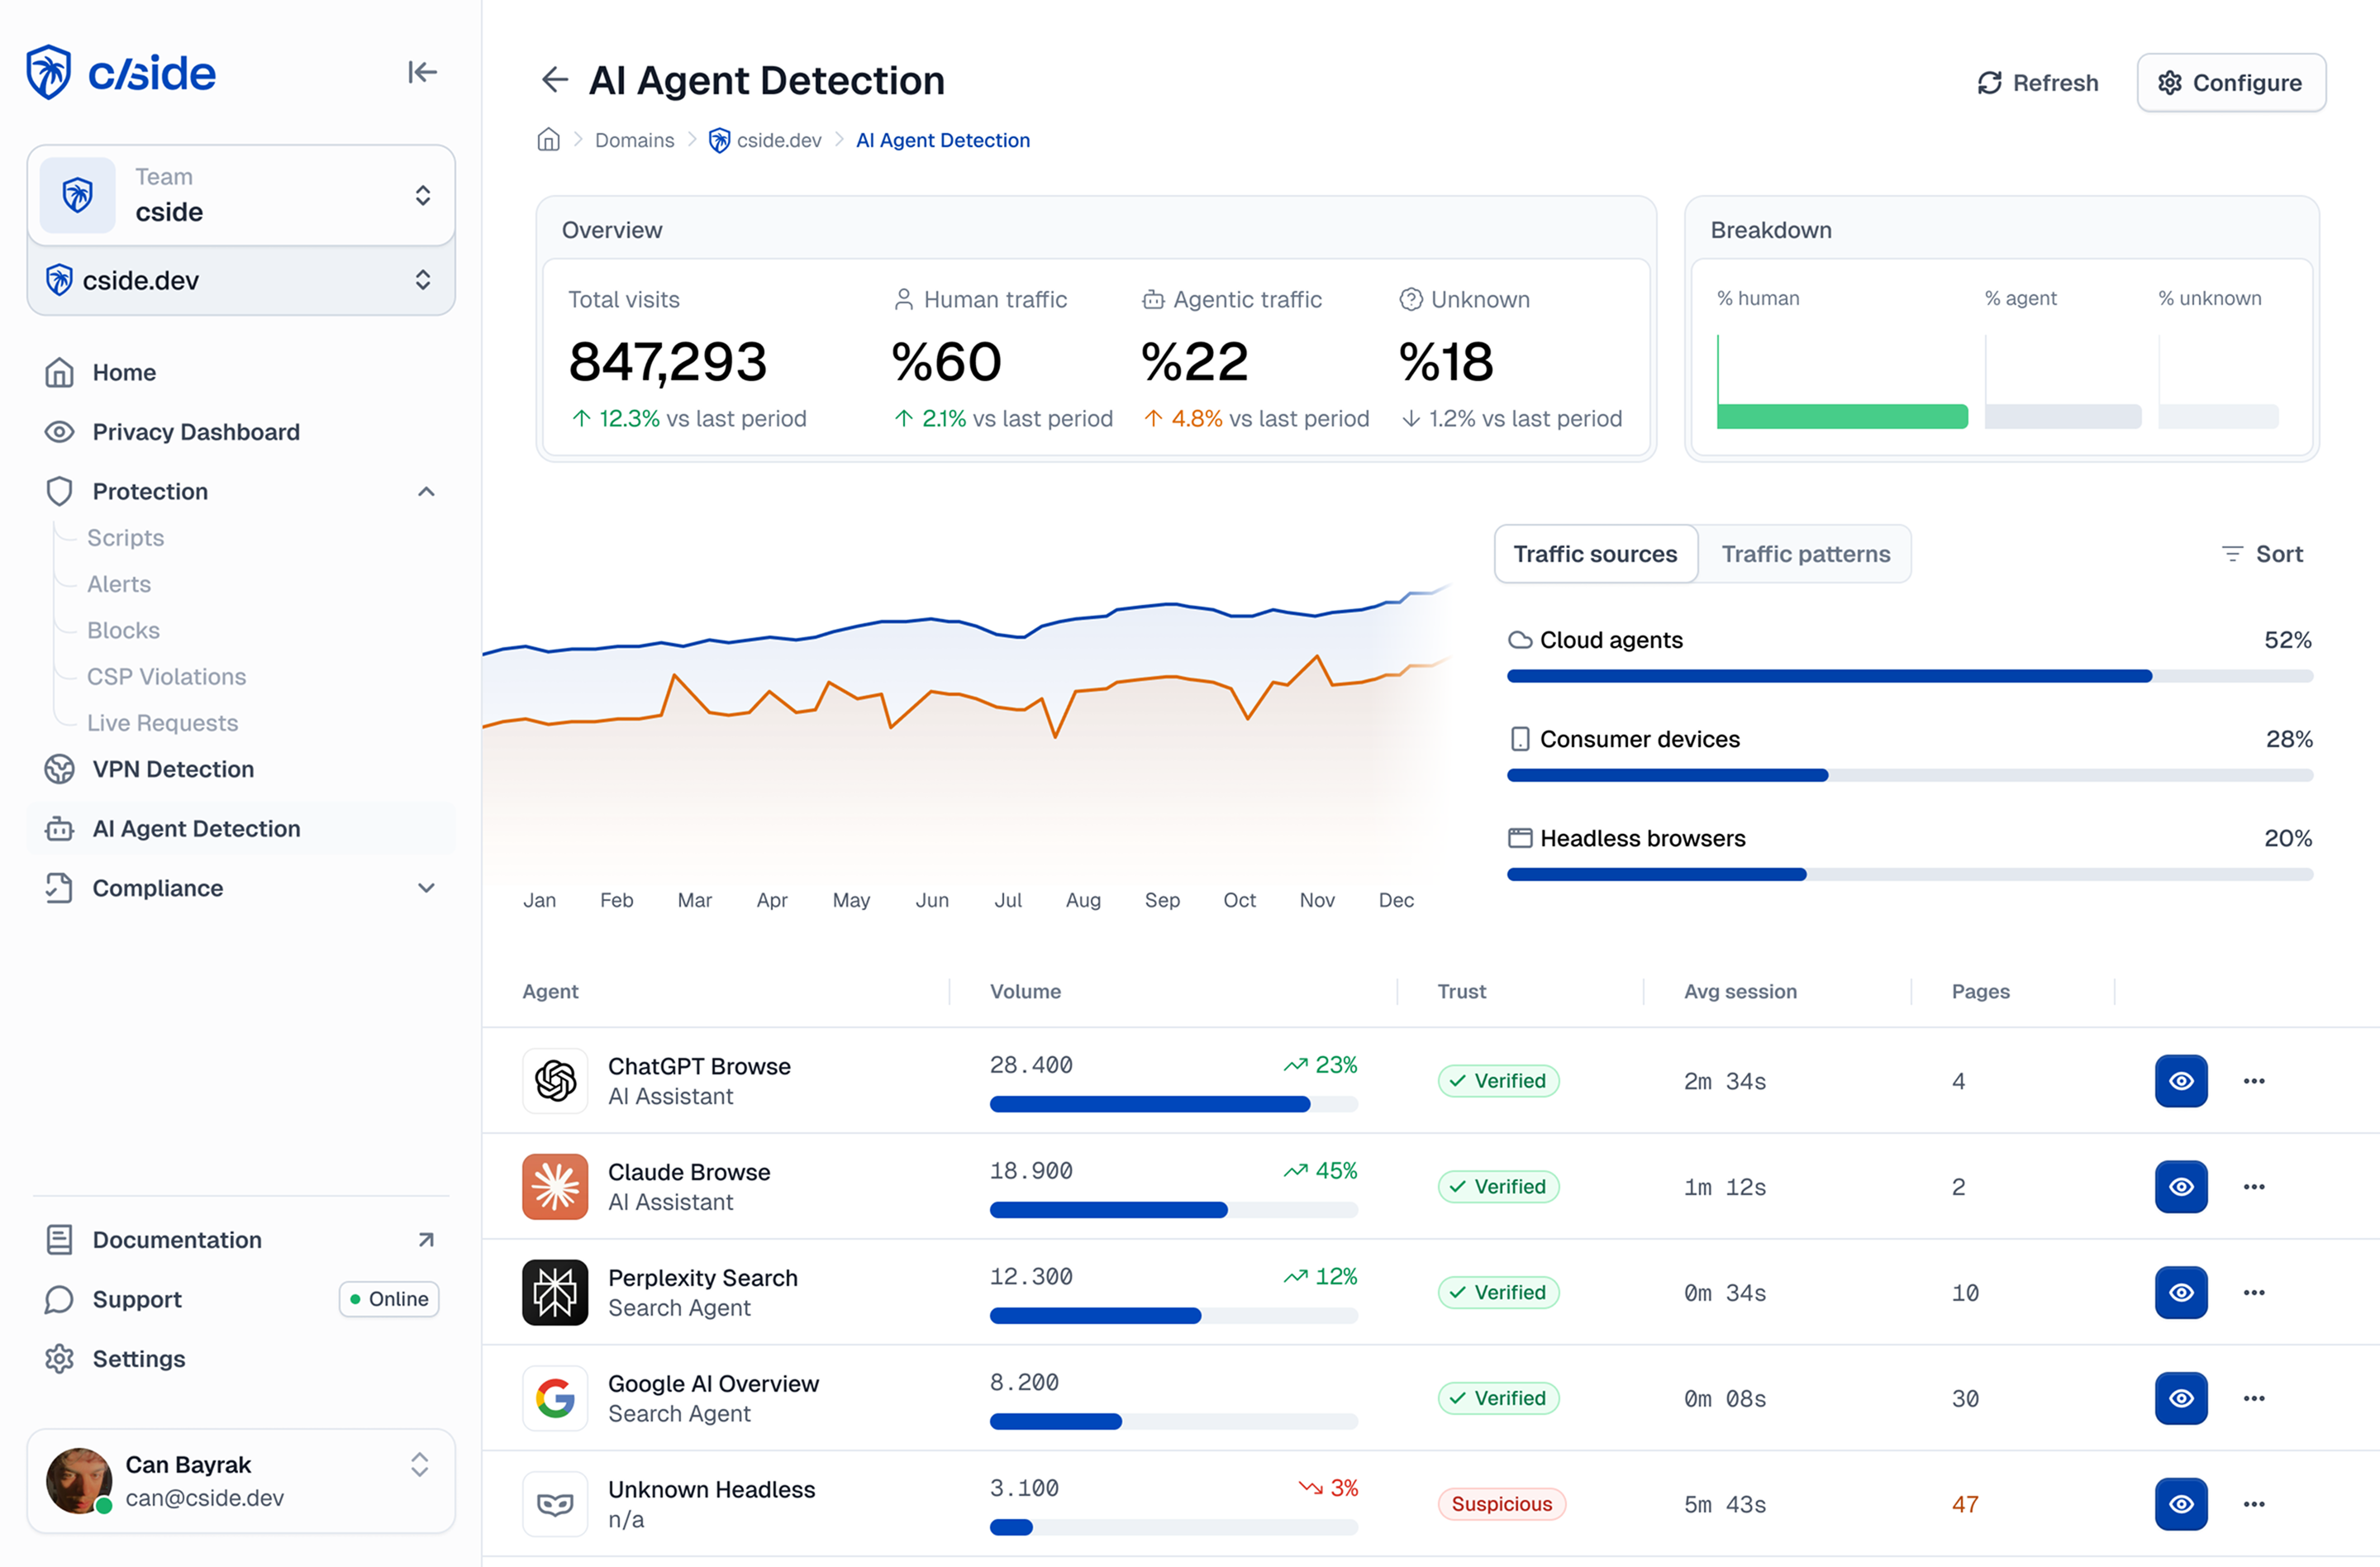
A cside opera dentro da sessão do navegador e expõe os sinais comportamentais que distinguem a navegação executada por agentes do comportamento humano. O tempo de interação, os padrões de navegação, a consistência da impressão digital e as características de execução de JavaScript são todos observáveis dentro de uma sessão de navegador, mas invisíveis para as ferramentas da camada de rede. O próprio ClaudeBot não está nessa categoria: é facilmente bloqueado. Os agentes que operam através de sessões de navegador são exatamente o que esses testes identificaram como a ameaça invisível.