
Resumo: como a deteção comportamental de bots estilo Reddit responde ao movimento aprendido
- A geometria não denuncia: O argumento de marketing do navegador stealth é que uma trajetória de cursor curvada derrota a deteção de movimento. Não derrota. Os humanizadores prontos a usar, incluindo curvas bezier, WindMouse e NaturalMouse, são apanhados 97% a 100% das vezes por um modelo de movimento de desktop. A geometria nunca foi o que denunciava o bot.
- A ferramenta human_nav: A cside construiu o human_nav, com três políticas de aprendizagem por reforço para cursor, scroll e teclas, treinadas contra cópias congeladas de detetores da cside. Contra esses críticos congelados atinge a banda humana; contra um detetor vivo desviado, a separabilidade do scroll fica em torno de AUC 0,77 e a cadência pode cair fora do intervalo humano.
- A vantagem do defensor: Se a tua defesa é um modelo comportamental estático, uma política aprendida convergirá sobre ele. Se recapturas o movimento humano e retreinas num calendário, pontuas coerência entre canais, e sobrepões movimento a sinais de fingerprint, rede e TLS, o atacante tem de vencer cada camada em simultâneo.
Sem tempo? Veja a deteção de agentes de IA da cside. Cobre tudo o que se segue numa única implementação.
Em um artigo anterior fizemos uma afirmação. Seja como for que um script desenhe o cursor, quer o teleporte direto ao alvo, siga uma curva bezier ou rode uma biblioteca de física como WindMouse ou NaturalMouse, um modelo de movimento o pega mesmo assim. A forma de um movimento é só metade do que uma mão deixa para trás. Mostramos que o mesmo vale para Playwright e a API "humanlike" da browserless.io.
Isso levanta a pergunta óbvia do outro lado da mesa. E se você parasse de desenhar a forma à mão e aprendesse o resto? Construímos a ferramenta que faz isso. Ela se chama human_nav: uma ferramenta de red team de pesquisa que sintetiza movimento humano de cursor, rolagem e digitação para testar a detecção comportamental de bots. Isto é o que ela revelou sobre os sites que mais se apoiam na biometria comportamental.
A versão curta:
- Humanizadores prontos (curvas bezier, WindMouse, NaturalMouse) são pegos de 97% a 100% das vezes por um modelo de movimento de desktop. A geometria nunca foi a resposta.
- O human_nav joga fora a geometria ajustada à mão. Três pequenas políticas de aprendizado por reforço geram trajetórias de cursor, janelas de rolagem e tempo de digitação, treinadas em movimento humano real: cadência, reversões, a pausa entre palavras.
- Contra os detectores congelados em que foi treinado, ele alcança a faixa humana. Contra um detector ao vivo que derivou, a lacuna reabre. A separabilidade da rolagem fica em torno de um AUC de 0,77, a política de cursor ainda pode ficar acima de um limiar ao vivo, e a cadência de digitação pode cair fora da faixa humana.
- O resultado pende para os defensores. A forma é um problema resolvido para o atacante. O que ainda separa uma política de uma pessoa é a estabilidade da cadência, a coerência entre canais e um detector que continua se movendo.
Por que estes são os alvos difíceis
As defesas contra bots que sobrevivem a um operador competente não são as que checam se o navegador é headless. Essa batalha foi ganha e perdida anos atrás. As defesas que ainda mordem observam como a sessão se comporta: o micro-timing de uma rolagem, a hesitação de um cursor, o ritmo da digitação em uma caixa de busca. Os grandes marketplaces, as redes profissionais e os feeds sociais de alta rotatividade, os Amazon, LinkedIn e Reddit da web, se apoiam nesta camada, porque é a que um navegador furtivo e um fingerprint limpo não passam de graça.
Isso os torna o alvo certo para apontar uma ferramenta de red team comportamental. Não para quebrá-los, mas para descobrir quanto dessa camada comportamental é segurança real e quanto é um quebra-molas que dobra no momento em que o movimento vem de algo melhor que uma curva bezier. Então construímos esse algo melhor.
O que é biometria comportamental?
Biometria comportamental é a disciplina de identificar e distinguir usuários de bots com base em como eles se comportam, não no que apresentam como credenciais. Onde a autenticação verifica uma senha ou um atributo de dispositivo, a biometria comportamental lê o fluxo contínuo de sinais que uma pessoa produz durante a interação: a curva de um cursor enquanto busca pela tela, o ritmo das teclas em um formulário, a física de uma rolagem ao desacelerar e recuar.
Esses padrões são difíceis de falsificar porque refletem milhões de microdecisões tomadas pelo sistema nervoso humano. O movimento do cursor carrega a antecipação e a pequena correção que um braço real produz. O timing de teclas reflete hábitos individuais: as pausas específicas nas bordas de palavras, a duração de pressão em teclas frequentemente erradas. A dinâmica de rolagem carrega a inércia de um polegar desacelerando no final de uma seção. Um processo scriptado não tem nada disso.
Biometria comportamental é agora uma camada padrão na detecção de bots, prevenção de fraudes e pontuação de risco de sessão em escala. Grandes plataformas se apoiam nela porque captura automações que já passaram por verificações de fingerprint de dispositivo e navegador headless. A cside usa sinais comportamentais como uma camada em uma cascata ao lado de fingerprints de dispositivo, sinais de rede e recursos TLS, para que um bot que aprende a se mover como uma mão ainda tenha que vencer todas as outras verificações ao mesmo tempo. O restante deste artigo mede o quão perto uma política de movimento aprendido pode realmente chegar.
Como o human_nav funciona
A ideia é estreita. Não crie scripts para o movimento. Amostre-o de uma política que aprendeu como o movimento humano se parece. Três modelos separados, cada um uma pequena política de aprendizado por reforço rodando localmente, cada um dono de um canal.
Cada movimento, rolagem e tecla é roteado por um servidor de políticas local antes de tocar a página. A automação pede "vá para B" ou "digite isto", e a política devolve o movimento exato, ponto a ponto, para reproduzir.
| Canal | Observação → ação | Emite | Parâmetros |
|---|---|---|---|
| Cursor | 19 → 3 | trajetória A→B de passos (dx, dy, dt ms) | ~40k |
| Rolagem | 13 → 2 | janela de roda de ticks (dy, dt) | ~9k |
| Digitação | 33 → 2 | tempo (hold, flight) por tecla | ~35k |
Cada uma é um MLP ator-crítico compacto treinado com PPO: PyTorch puro, CPU, uma política gaussiana com esmagamento tanh, normalização de observações em andamento, um bônus de entropia, uma parada antecipada por KL alvo. Nada disso é exótico. O otimizador nunca foi o ponto. A recompensa é.
Aqui está o que a distingue de qualquer humanizador pronto. Uma biblioteca bezier otimiza a aparência de uma trajetória. Estas políticas são avaliadas por cópias congeladas dos próprios detectores da cside, e recompensadas no espaço de logits por produzir movimento que esses detectores leem como humano. Elas não desenham uma curva mais bonita. Resolvem aquilo de que a curva sempre foi apenas um substituto.
Dentro da política de cursor
O agente de cursor vê uma observação de 19 dimensões: o vetor até o alvo, seu último (dx, dy, dt), o índice do passo, o comprimento acumulado da trajetória, o deslocamento líquido, estatísticas correntes de velocidade e de tempo, uma contagem de mudanças de direção, uma razão de retidão e uma antecipação do próximo waypoint. Esse estado carregado de acumuladores é deliberado. Os detectores leem a cinemática agregada de toda a trajetória, então a política recebe estatísticas suficientes em andamento para exatamente os agregados pelos quais é julgada. Ela age emitindo um trio (dx, dy, dt) a cada passo, limitado a ±40 px e de 4 a 40 ms.
A recompensa é um portão. Um bônus de chegada de 20 domina tudo, então a política primeiro aprende a de fato chegar em B. Só na chegada ela coleta uma recompensa do detector, fixada na margem humana do crítico vinculante, o pior de dois avaliadores congelados: cursor_v2 (uma cabeça MLP, limiar em torno de 0,992) e cursor_v1 (uma cabeça LightGBM, limiar em torno de 0,828). Coloque ambos abaixo do limiar ao mesmo tempo e ela ganha um bônus de realismo por cima. O treino percorre um currículo: navegação pura primeiro, depois pressão crescente dos detectores contra os dois críticos juntos. Lutar contra dois detectores ao mesmo tempo é o que mantém as trajetórias limpas e suavemente curvadas, em vez de colapsar em um artefato que engana um avaliador e parece quebrado para o outro.
Seis trajetórias A→B reais saídas direto da política, determinísticas, mostram o cursor acelerando pelo meio e suavizando ao entrar no alvo, a desaceleração na aproximação que uma mão faz em vez de um deslizar a velocidade constante. A retidão mediana entre elas é de cerca de 0,99, sobre 12 a 26 pontos, a aproximadamente 38 ms por passo. O tempo por passo se mantém quase plano nos trinta e poucos milissegundos. A política descobriu que o micro-timing estável, não o jitter, é o que os detectores congelados leem como humano.
Esta solução é uma agulha afiada e determinística. A ação média da política é o que cai na faixa humana. Amostre-a de forma estocástica, ou adicione seu próprio ruído por cima, e o realismo desmorona. A aleatoriedade é exatamente o que a automação ingênua busca, e aqui é o que entrega. A vitória também é estreita. É um exploit adversarial de um detector congelado, não movimento humano certificado.
Rolagem e digitação
A política de rolagem emite (dy, log1p(dt)) por tick de roda. O tempo é gerado em espaço logarítmico e remapeado de volta, então uma única política cobre tudo, de rajadas de menos de 10 ms a pausas de acomodação de um segundo. Ela amostra suas tarefas de rolagem, o comprimento, a distância líquida e as reversões, de um banco de rolagens humanas reais. Cada janela gerada entra e sai suavemente em vez de subir em linha reta, e as reversões de direção caem em lacunas mais longas, uma pessoa que pausa antes de corrigir.
A política de digitação roda em uma observação de 33 dimensões cuja cauda é um one-hot das categorias da tecla atual e das duas seguintes (letra, dígito, espaço, edição), e emite um par (hold, flight) por tecla. Os tempos de hold ficam perto de 150 ms, mas as lacunas de flight carregam o sinal.
| Tempo de digitação | Valor |
|---|---|
| Tempo de hold | ~150 ms |
| Flight dentro da palavra | 250 a 350 ms |
| Flight no limite da palavra | ~850 ms |
A política aprendeu a pausar entre palavras, um ritmo que um atraso fixo entre teclas nunca produz. Essa é a ideia toda. Troque a geometria escrita à mão por uma política aprendida por canal, avalie-a contra um detector real, e deixe-a encontrar as partes do movimento humano que uma pessoa escrevendo mouse.move() nunca pensaria em codificar: a desaceleração na aproximação, a pausa antes de uma correção, o compasso entre palavras.
Onde essas trajetórias caem
Uma forma de ver o que a política nos comprou: pegue uma pilha de trajetórias geradas, dos humanizadores ingênuos e do human_nav, reduza cada uma a dez características cinemáticas, e projete o todo em três dimensões com PCA. As famílias de reta com jitter e de bezier se sentam em seus próprios aglomerados apertados, porque há apenas tantas formas de desenhar uma curva de aparência suave. A política se espalha por uma região mais ampla e mais bagunçada, mais próxima de como o movimento real de uma mão se dispersa, que é a propriedade que uma curva fixa não consegue produzir.
Leia isto com honestidade. A projeção cobre 440 trajetórias de quatro geradores sintéticos, com 77% da variância contida em três eixos. Ela compara geradores sintéticos entre si, não contra capturas humanas reais. Então a conclusão é "a política ocupa uma região diferente e mais ampla que os humanizadores prontos", não "a política é indistinguível de um humano".
Quão perto ela chega de verdade
Aqui é onde a honestidade importa mais que a manchete. Contra os detectores congelados em que as políticas foram treinadas, elas vencem. É isso que "treinado contra eles" significa, e por si só não prova quase nada. O teste real é um detector que a política nunca viu, e idealmente um que tenha derivado desde então. Aí o quadro é misto, e a mistura é a conclusão.
| Canal | Contra o detector congelado | Contra um detector ao vivo que derivou |
|---|---|---|
| Cursor | Na faixa humana | Pode ficar acima de um limiar ao vivo. Não é humano certificado. |
| Rolagem | Na faixa humana | Separável em torno de um AUC de 0,77. Realista, não invisível. |
| Digitação | Na faixa humana | A taxa de pausa e a velocidade podem cair fora da faixa humana. |
Leia essa tabela como um defensor deveria. Uma política aprendida é um grande salto em relação a uma curva bezier. Ela fecha a maior parte da lacuna de geometria que os humanizadores prontos nunca tocam. Mas "plausivelmente humano contra o detector em que treinei" não é "humano". No momento em que o detector do outro lado é um que ela nunca estudou, ou um que se moveu desde o treino, o sinal residual volta. O realismo do movimento decai sob a deriva, e a deriva é a única coisa que um defensor controla por completo.
O que isto significa se você roda detecção comportamental
Algumas coisas decorrem, e são a razão pela qual construímos ferramentas de red team.
Primeiro, não implante uma verificação comportamental e a congele. Qualquer política treinada contra um detector estático vai acabar igualando-o. A defesa mais eficaz nessa tabela é a coluna da direita: recapturar e retreinar segundo um cronograma. Isso não é manutenção, é o mecanismo de verdade. Um detector que se move mais rápido do que um atacante consegue retreinar é um em que ele nunca converge.
Segundo, avalie a coerência, não os canais isoladamente. Uma política que domina o movimento de cursor e uma política que domina a digitação continuam sendo dois amostradores separados. As correlações que uma pessoa real produz entre mover, rolar e digitar são muito mais difíceis de falsificar do que qualquer canal isolado, porque ninguém treinou uma política na distribuição conjunta. Essa costura é onde um conjunto de boas falsificações de canal único se desfaz.
Terceiro, mantenha o comportamental como uma camada, não a camada. O movimento comportamental é poderoso, e também é a camada mais exposta a um humanizador determinado. Combine-o com sinais de fingerprint, rede e TLS, do jeito como a stack da cside decide o is_bot como uma chamada combinada em vez de confiar em um único modelo, e um operador tem de vencer todas as camadas ao mesmo tempo, não só aquela em que afundou uma política aprendida. Esse é o argumento a favor de uma cascata, e é por isso que a detecção de bots aguenta quando uma única verificação dobraria.
Divulgação responsável. Este relato cobre a técnica e seus limites no nível dos resultados. Deixa de fora os internos do detector, os limiares, as definições de características por canal e qualquer procedimento de ajuste, a mesma linha que nossos outros artigos públicos mantêm. A própria ferramenta está disponível para download abaixo. Qualquer coisa aqui que toque uma plataforma externa foi compartilhada com essa plataforma antes da publicação.
Agentes de navegação com LLM: uma nova assinatura comportamental
O human_nav descreve uma classe de ataque: um desenvolvedor que otimiza explicitamente o movimento contra um detector conhecido. Uma segunda classe surgiu em 2025 e 2026: automação de navegador conduzida por grandes modelos de linguagem, onde o agente não é uma política treinada em movimento mas um modelo de raciocínio que dirige um navegador Playwright ou Puppeteer via visão e chamadas de ferramentas.
Agentes de navegação com LLM não se movem como bots scriptados, e não se movem como o human_nav. Eles têm sua própria assinatura comportamental, que um detector construído para qualquer uma das duas classes de ataque mais antigas pode perder completamente.
Os padrões característicos:
- Cadência de latência de API. Um agente LLM faz uma pausa enquanto o modelo raciocina sobre a próxima ação, depois dispara um clique com precisão incomum. Os intervalos entre ações refletem o tempo de inferência, não a deliberação humana. Os cliques chegam sem hesitação de seguimento de trajetória e sem correções de ultrapassagem.
- Padrões de varredura metódica. Um modelo de linguagem direcionado para preencher um formulário lê a página inteira antes de começar. O movimento do cursor reflete uma varredura sistemática de cima para baixo que não se parece em nada com o movimento orientado a objetivos de uma pessoa que já sabe onde está o campo alvo.
- Timing em burst. Ações disparadas de uma única invocação do modelo chegam em clusters cujos intervalos entre ações refletem a taxa de tokens de saída do modelo em vez de qualquer ritmo humano.
Essas assinaturas são significativas para uma verificação comportamental não treinada nelas. Elas também são legíveis ao lado de sinais de camada de fingerprint e rede, porque sessões de navegador direcionadas por máquina ainda rodam em infraestrutura identificável.
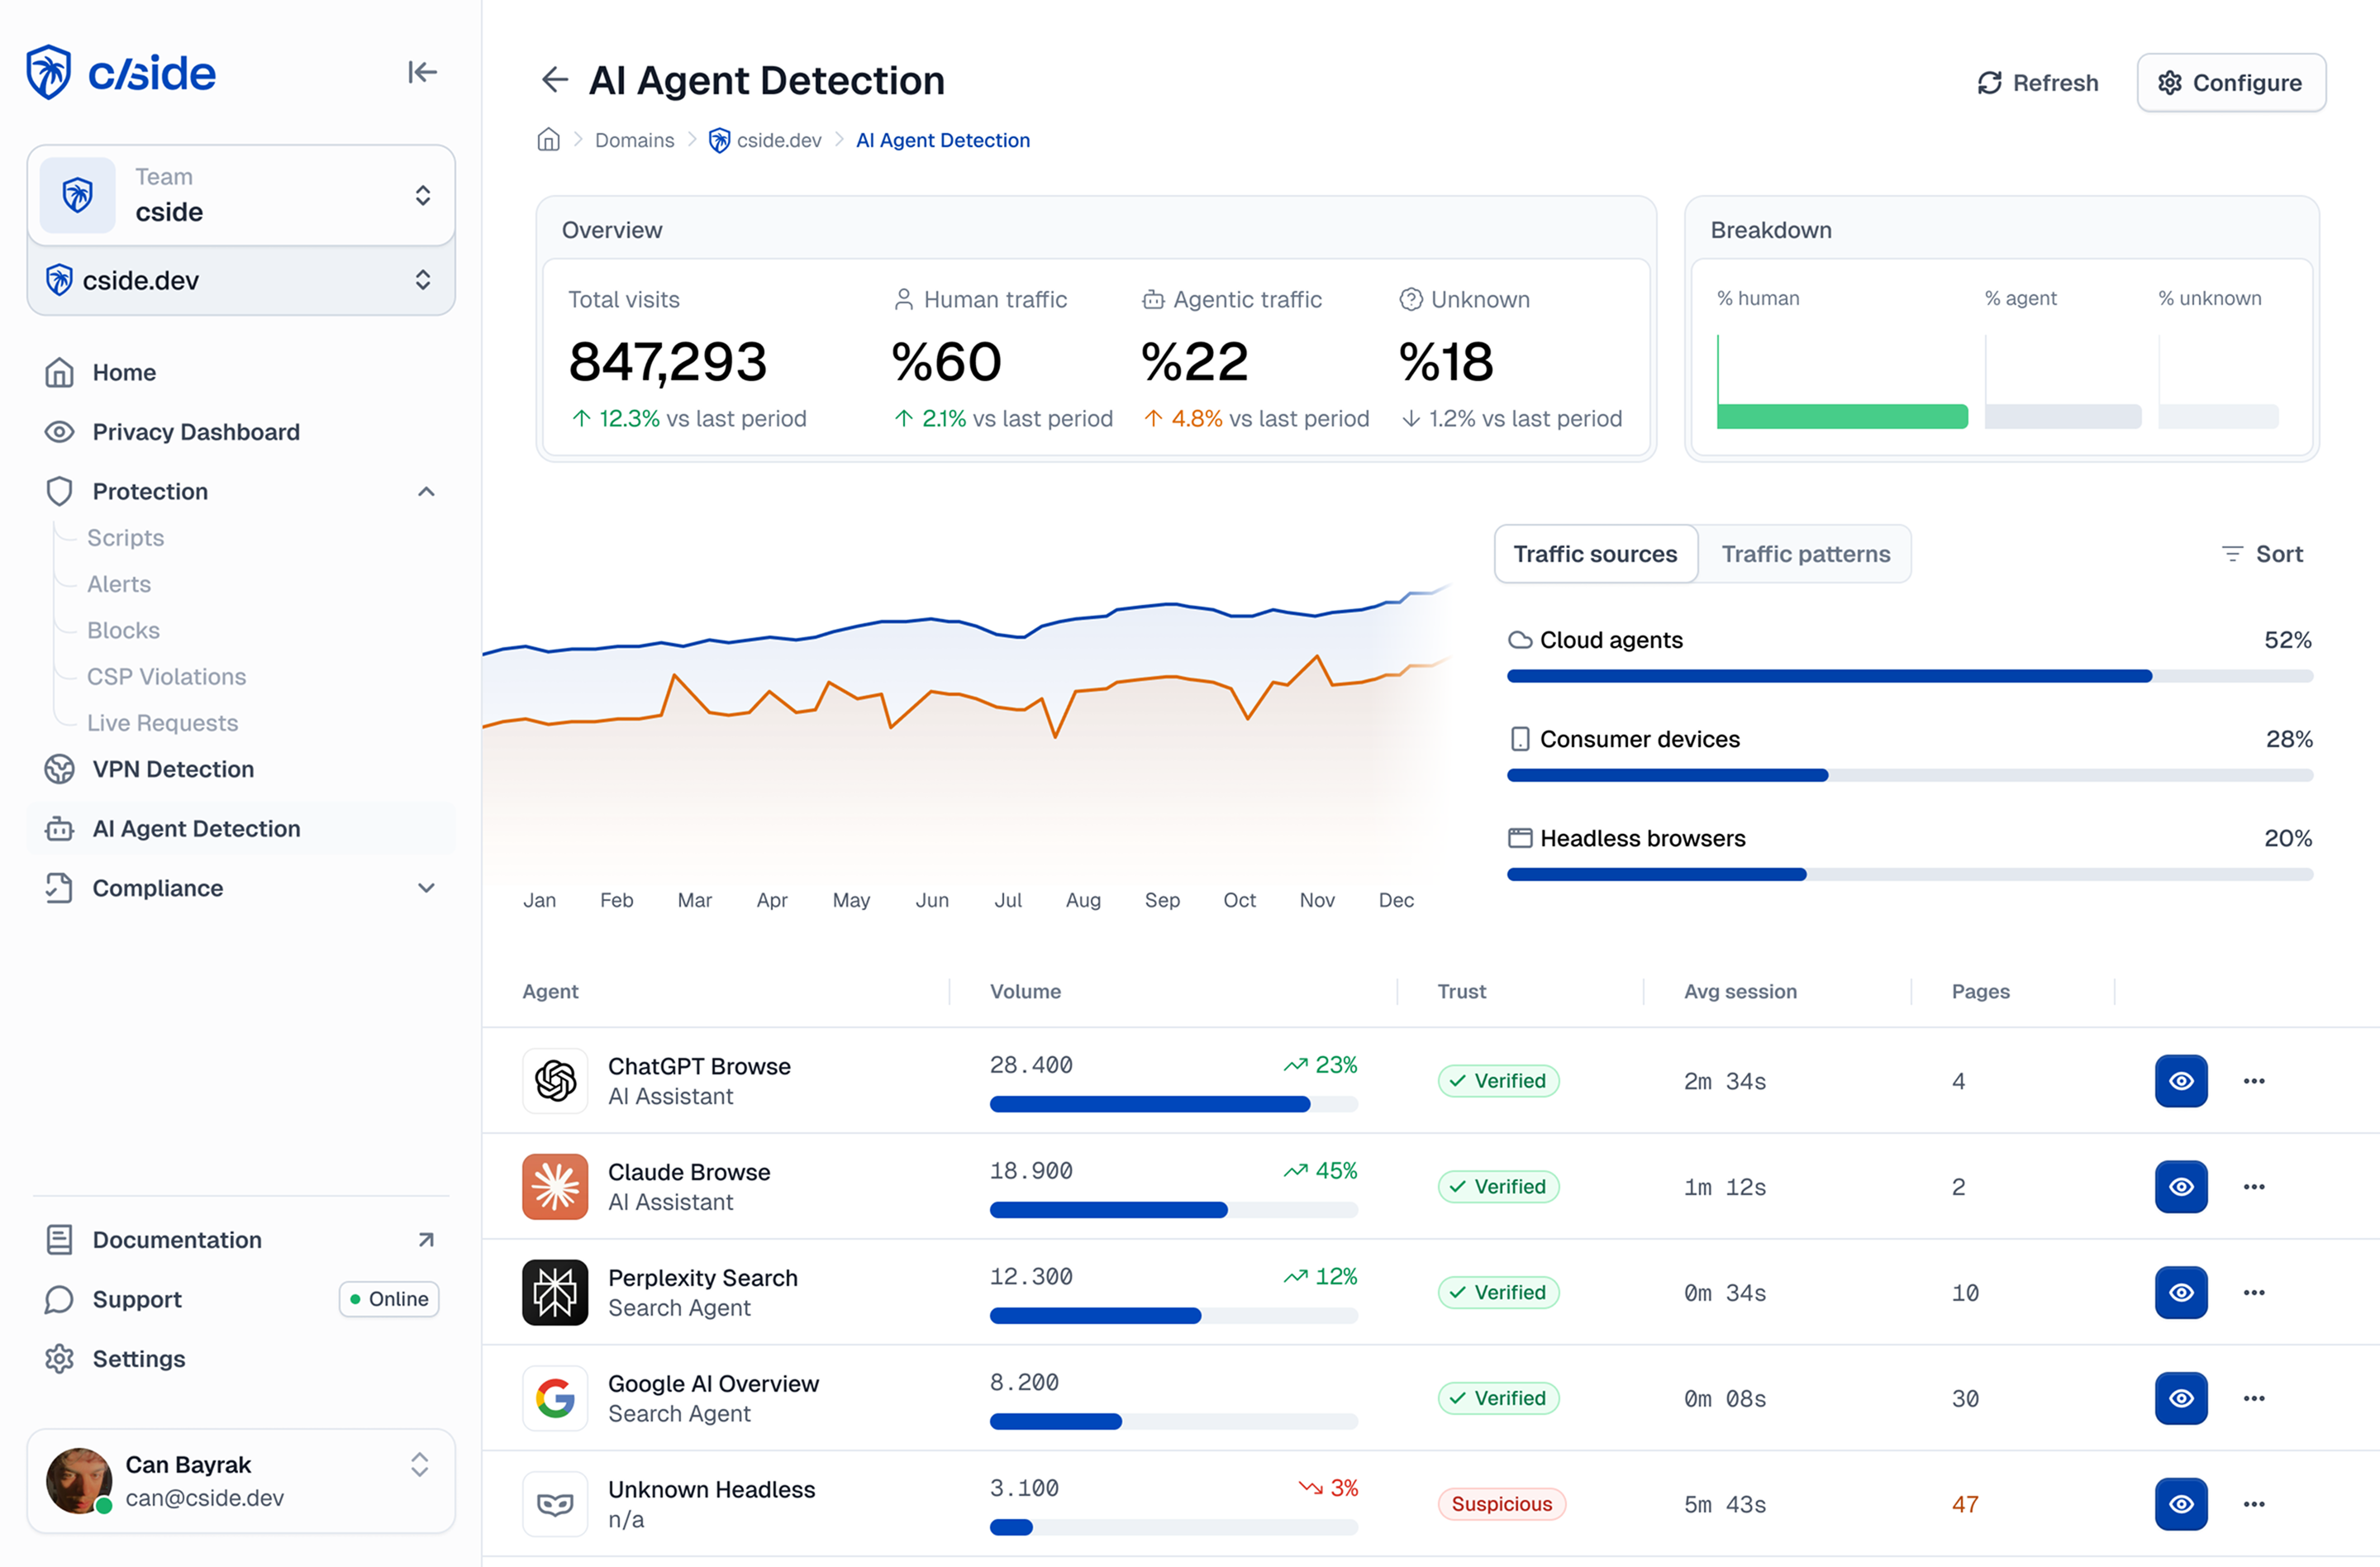
A lição do human_nav se aplica: pontuar coerência entre canais, movimento, fingerprint, rede e timing, é o que uma política aprendida não consegue vencer de uma vez, seja essa política um agente de RL ou um modelo de raciocínio dirigindo um navegador. A detecção de agentes de IA da cside aplica exatamente essa cascata a cada sessão.
O sentido de construir o atacante
É fácil ler o human_nav como uma ferramenta de evasão que por acaso vive em uma loja de detecção. Nós o construímos pela razão oposta. A única forma de saber se uma defesa comportamental é segurança real ou um quebra-molas é construir o melhor atacante que você conseguir e medir exatamente onde ele para de funcionar. A resposta aqui é útil de qualquer jeito. O movimento aprendido vence a geometria, e ainda assim não vence um detector que continua se movendo e lê mais de um canal ao mesmo tempo. Esse é um resultado incômodo se você vende automação "humanlike", e tranquilizador se o seu trabalho é manter os bots do lado de fora.
A cside mostra cada script e cada sessão que toca o seu site, incluindo a automação que aprendeu a se mover como uma mão. Veja o que está realmente rodando nos navegadores dos seus usuários.