
Resumen: bloquear ClaudeBot sin detener a los agentes Claude que navegan tu sitio
- Crawler frente a agente: Los equipos bloquean ClaudeBot esperando que Claude desaparezca de su sitio, y al día siguiente Claude Computer Use entra caminando. ClaudeBot es el rastreador de entrenamiento de Anthropic; los agentes impulsados por Claude que navegan la web usan infraestructura y user-agents distintos.
- El bloqueo por robots.txt: ClaudeBot se identifica como
Claude-Web/1.0, está documentado en las páginas de crawler de Anthropic y respeta robots.txt de forma fiable; unDisallow: /más los rangos de IP publicados de Anthropic en el firewall cubre en una sola capa de aplicación tanto la lectura de robots.txt como el comportamiento no conforme. - La decisión: Si quieres salir de los datos de entrenamiento de Claude, este cambio de un archivo lo hace. Si además quieres mantener a Claude Computer Use fuera de tu checkout, ese es un problema de detección separado que requiere señales de capa de navegador.
¿Poco tiempo? Consulta la detección de agentes de IA de cside. Cubre todo lo de abajo en un solo despliegue.
ClaudeBot es el rastreador web operado por Anthropic para recopilar datos de entrenamiento para Claude. Es un rastreador declarado y basado en HTTP: se identifica, opera desde rangos de IP publicados y está diseñado para respetar las directivas de robots.txt. Bloquearlo es técnicamente sencillo.
El contexto más importante: bloquear ClaudeBot aborda el flujo de datos de entrenamiento de Anthropic. No tiene ningún efecto sobre los agentes, herramientas o productos impulsados por Claude que navegan por la web en nombre de los usuarios. Esos son sistemas independientes que requieren detección en la capa del navegador. Para conocer el patrón más amplio en los scrapers de IA, consulta nuestra guía para bloquear bots de IA que hacen scraping de contenido.
¿Qué Es ClaudeBot?
Respuesta rápida: ClaudeBot es el rastreador de entrenamiento de Anthropic. Recopila contenido web de acceso público para entrenar y mejorar los modelos Claude. Utiliza una cadena de agente de usuario declarada y aparece listado en la documentación pública de Anthropic junto con sus rangos de IP. Es un rastreador HTTP, no un agente de navegador interactivo.
El identificador principal de agente de usuario de ClaudeBot es Claude-Web/1.0, con una referencia a la página de documentación del rastreador de Anthropic. Anthropic mantiene documentación que describe el propósito, el comportamiento y la forma de bloquear el rastreador.
Al igual que GPTBot, ClaudeBot no ejecuta JavaScript ni interactúa con las interfaces de aplicaciones web. Realiza solicitudes HTTP GET a URLs de acceso público, lee la respuesta y sigue adelante. No inicia sesión, no rellena formularios ni navega por elementos interactivos.
Cómo Bloquear ClaudeBot con robots.txt
Respuesta rápida: Añade
ClaudeBota turobots.txtpara bloquear el rastreador por completo. La documentación de Anthropic indica que ClaudeBot respeta estas directivas. Usa reglas a nivel de ruta si quieres restringir solo las secciones sensibles mientras permites el rastreador en el contenido público.
Para bloquear ClaudeBot en todo tu sitio:
User-agent: ClaudeBot
Disallow: /
Para permitir el rastreador en el contenido público pero restringir las rutas sensibles:
User-agent: ClaudeBot
Disallow: /account/
Disallow: /checkout/
Disallow: /admin/
Allow: /blog/
Allow: /products/
Anthropic tiene buena reputación de cumplimiento en cuanto a que sus rastreadores respetan las reglas de robots.txt. Este es el enfoque más sencillo y de mayor alcance para controlar el acceso de ClaudeBot sin cambios a nivel de infraestructura. El mismo enfoque de robots.txt funciona para otros rastreadores declarados, incluidos CCBot y Bytespider.
Bloqueo a Nivel de IP para ClaudeBot
Respuesta rápida: Anthropic publica los rangos de IP de ClaudeBot en la documentación de su rastreador. Denegar estos rangos en tu firewall o CDN proporciona una aplicación que no depende de que el rastreador lea el
robots.txt. Revisa la documentación periódicamente, ya que los rangos de IP pueden ampliarse cuando Anthropic escala su infraestructura de rastreo.
El bloqueo a nivel de IP es la opción de aplicación más robusta:
- Captura cualquier versión del rastreador que pueda no gestionar correctamente el
robots.txt - Crea un registro a nivel de servidor de las solicitudes bloqueadas que puedes auditar
- No depende de la autoidentificación a través de la cadena de agente de usuario
El inconveniente: los rangos de IP publicados por Anthropic requieren mantenimiento. Si los bloqueas a nivel de firewall, configura un recordatorio para comprobar las actualizaciones de los rangos trimestralmente o cuando Anthropic publique entradas de changelog en la documentación de su rastreador.
ClaudeBot vs. Agentes Impulsados por Claude: La Brecha que Importa
Respuesta rápida: ClaudeBot es el rastreador de Anthropic. Claude, el asistente, es un producto diferente. Cuando Claude ayuda a un usuario a navegar por la web, investigar un tema o completar una tarea, utiliza una infraestructura diferente a la de ClaudeBot. Bloquear ClaudeBot no impide que los agentes impulsados por Claude visiten tu sitio.
Esta es la misma brecha estructural que se aplica a GPTBot y a OpenAI Operator. El rastreador de entrenamiento y el agente interactivo son sistemas independientes.
Cuando un usuario le pide a Claude que investigue un producto, compare precios o complete una tarea basada en la web, Claude utiliza una sesión de navegador o una herramienta de búsqueda web que no es ClaudeBot. Esa sesión puede no tener ninguna cabecera identificativa que la vincule con Anthropic. Desde la perspectiva de tu servidor, parece una solicitud de navegador estándar.
El modelo mental correcto: robots.txt y el bloqueo de IP gestionan tu relación con el flujo de recopilación de datos de Anthropic. No gestionan tu relación con Claude como producto utilizado por usuarios reales para interactuar con tu sitio.
Qué Sucede Después de Bloquear ClaudeBot
Respuesta rápida: Bloquear ClaudeBot impide que tu contenido entre en el flujo de datos de entrenamiento de Anthropic. No impide que Claude haga referencia a tu sitio en sus respuestas basándose en contenido previamente indexado. No impide que los sistemas agénticos impulsados por Claude naveguen por tu sitio en nombre de los usuarios.
Después de un bloqueo de ClaudeBot:
- Los futuros entrenamientos no incluirán tu contenido nuevo
- El contenido recopilado previamente permanece en los pesos de los modelos Claude existentes
- Los usuarios de Claude que le piden que navegue por tu sitio no se ven afectados
- Cualquier agente impulsado por Claude (uso de ordenador de Claude.ai, agentes de la API de Claude) que visite tu sitio no se ve afectado
El alcance de un bloqueo de robots.txt es más reducido de lo que la mayoría de los propietarios de sitios espera. Es una declaración sobre un rastreador específico, no una política que se aplique a toda la cartera de productos de una empresa de IA.
Detección en la Capa del Navegador Más Allá de ClaudeBot
Respuesta rápida: Bloquear ClaudeBot es sencillo. El problema más difícil es detectar agentes impulsados por Claude que navegan por tu sitio en sesiones de navegador reales en nombre de los usuarios, sesiones que en la capa de red parecen idénticas al tráfico humano. Eso requiere observación en la capa del navegador.
Piensa en lo que hace realmente un agente de uso de ordenador impulsado por Claude cuando un usuario le pide que investigue un producto SaaS. Abre una sesión real de Chromium, carga la página de precios y se desplaza por la tabla de funciones. En la capa de red, la solicitud parece idéntica a una visita humana: un agente de usuario estándar de Chrome, una IP residencial, una huella digital TLS dentro del rango. Sin cabecera de ClaudeBot. Sin rango de IP de Anthropic. El agente navega por cuatro páginas en 11 segundos sin una sola variación en el movimiento del ratón, nunca retrocede en el desplazamiento y nunca se detiene en un campo de formulario a menos que la tarea requiera entrada de datos. Esas señales de tiempo y patrones de interacción solo son detectables dentro de la sesión del navegador. La instrumentación de cside los captura en la capa de ejecución de JavaScript antes de que cualquier herramienta a nivel de red pueda verlos. En las pruebas controladas de cside, las herramientas tradicionales pasaron por alto agentes de IA que operaban dentro de sesiones de navegador reales en 81 de cada 100 escenarios: las herramientas de red simplemente no están vigilando la capa correcta.
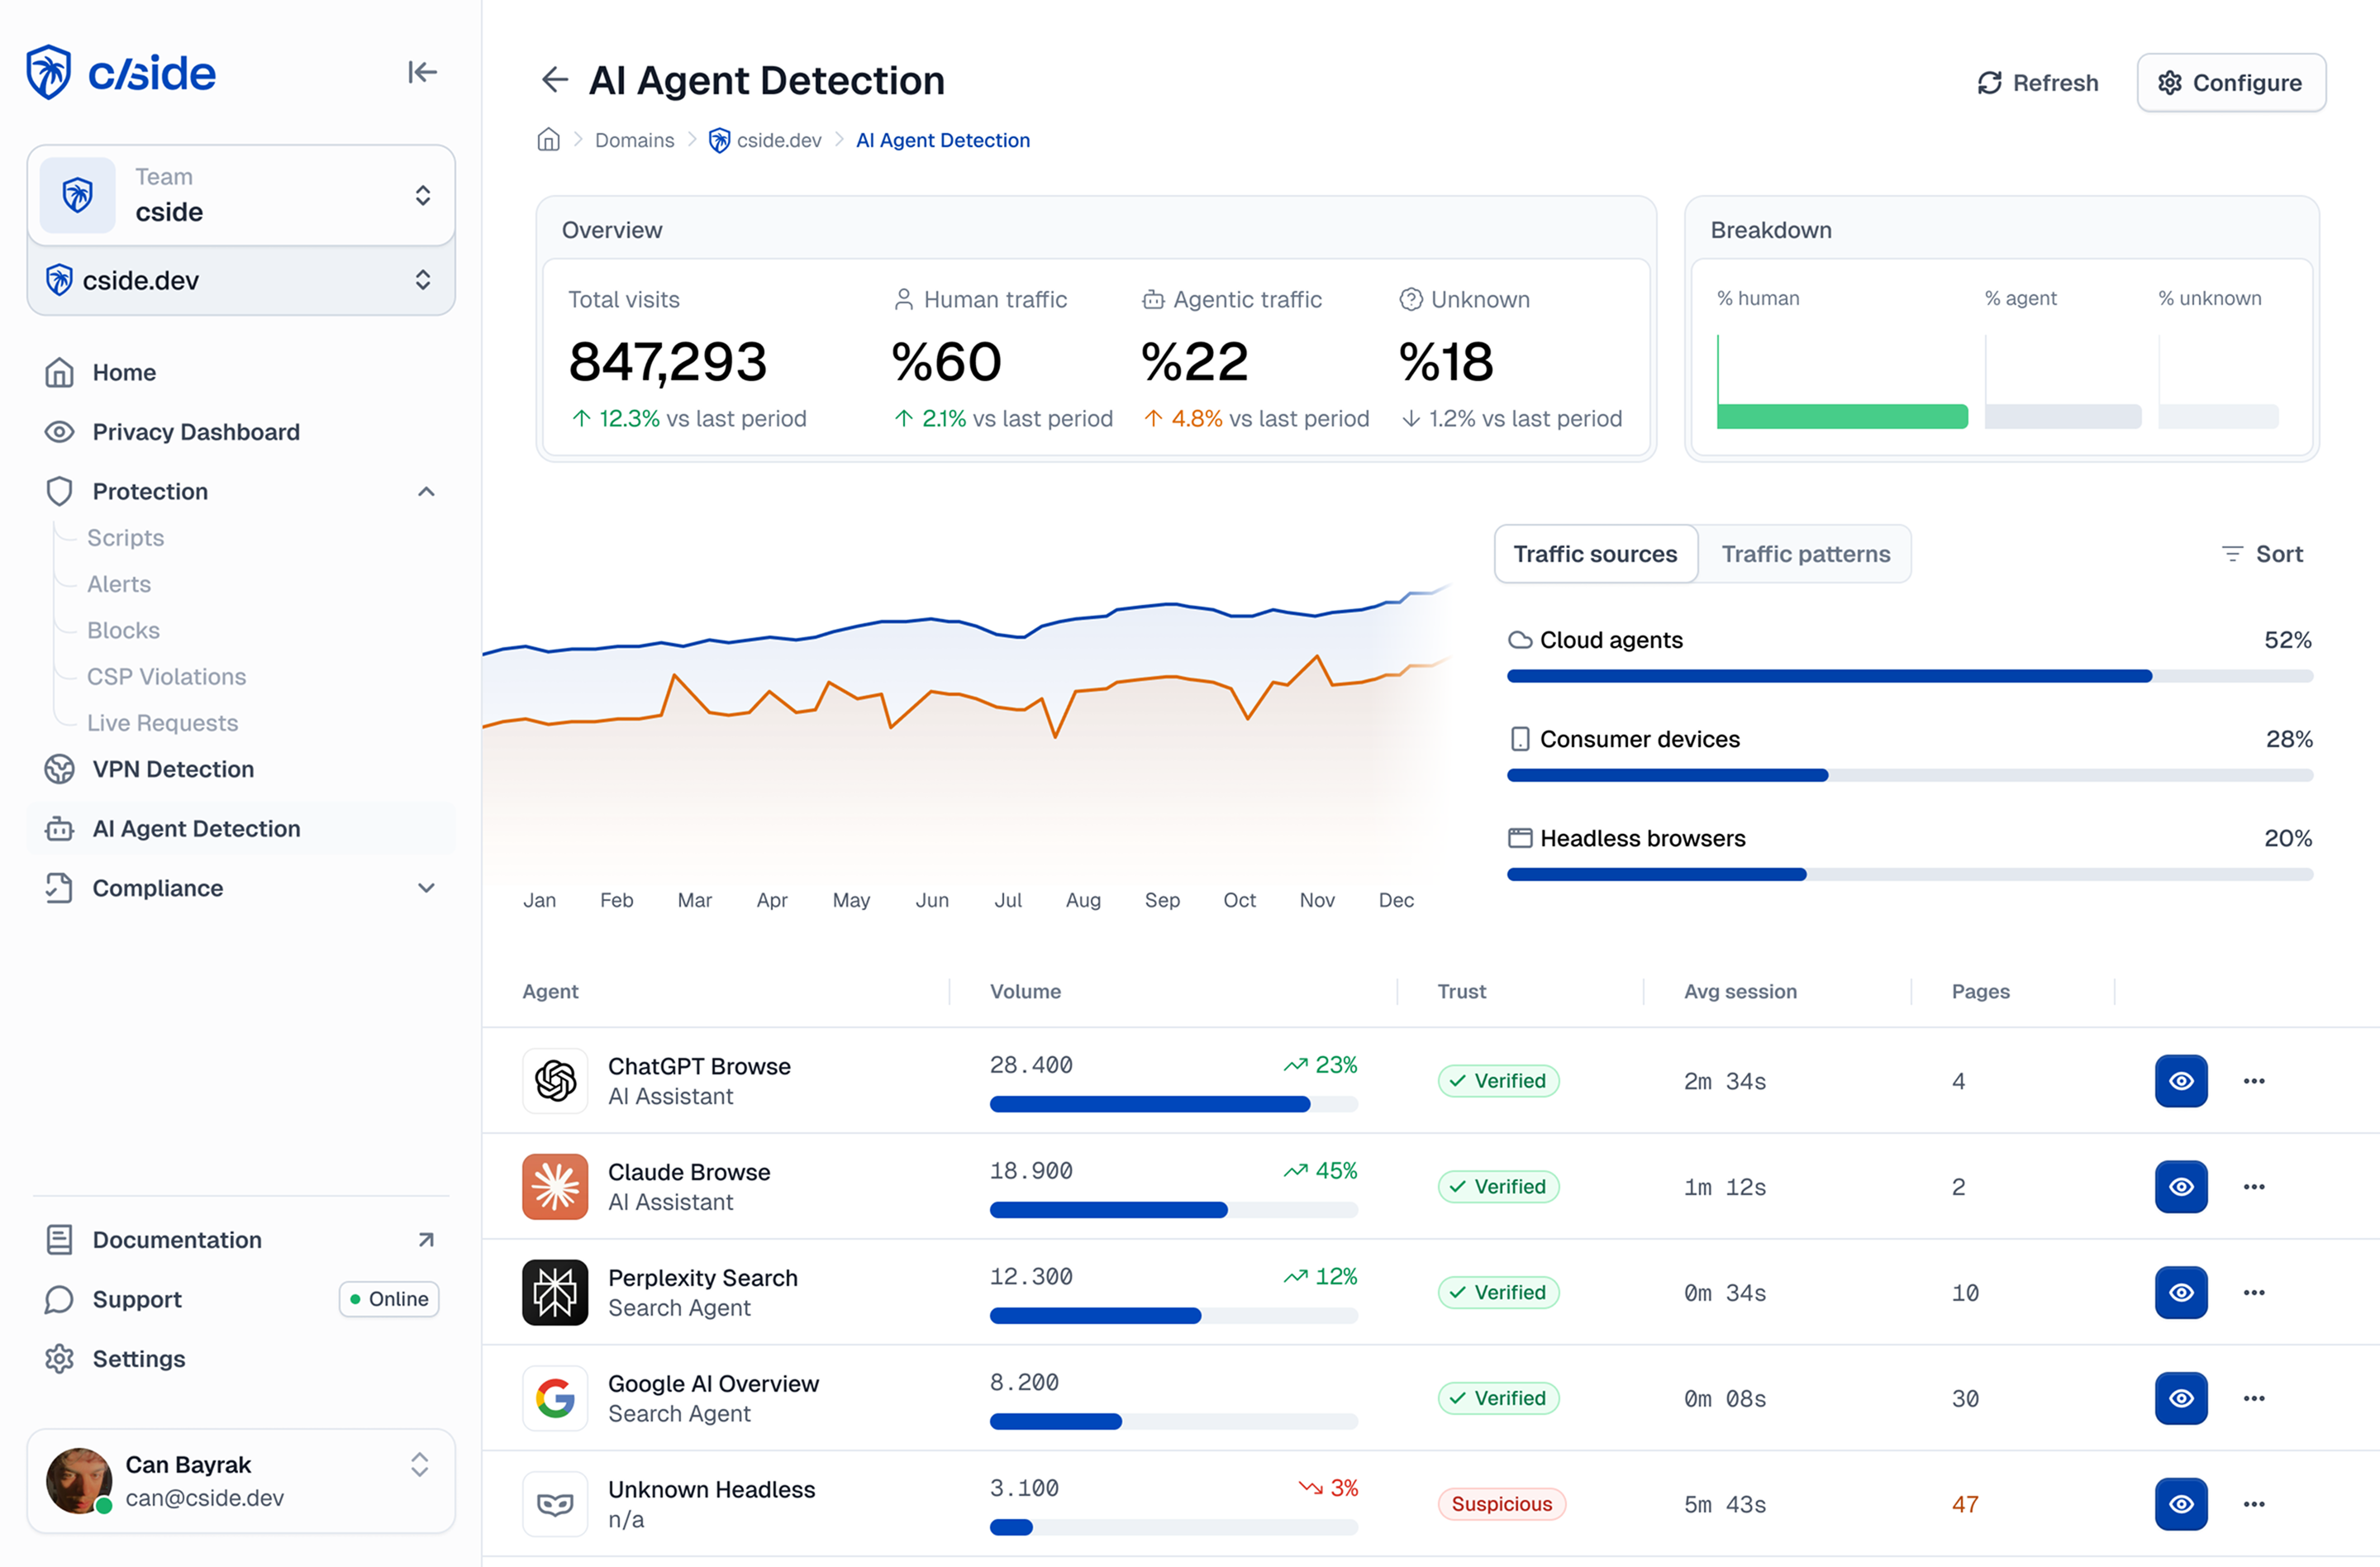
cside opera dentro de la sesión del navegador y saca a la luz las señales de comportamiento que distinguen la navegación ejecutada por un agente del comportamiento humano. El tiempo de interacción, los patrones de navegación, la consistencia de la huella digital y las características de ejecución de JavaScript son todos observables dentro de una sesión de navegador, pero invisibles para las herramientas de la capa de red. El propio ClaudeBot no entra en esa categoría: es fácil de bloquear. Los agentes que operan a través de sesiones de navegador son exactamente lo que esas pruebas identificaron como la amenaza invisible.



